X (antes Twitter) cuenta actualmente con una audiencia de casi 600 millones de usuarios activos mensuales, lo que la convierte en una valiosa fuente de datos para el entrenamiento de IA, la monitorización de marcas y el análisis de sentimiento. Sin embargo, esta es la realidad: los desarrolladores de Python siguen devanándose los sesos haciendo malabares entre tres opciones: la API oficial de X, scrapers propios y herramientas de terceros.
Este manual desglosa cada uno de los tres escenarios: scraping, la API oficial, y las API de terceros, como la API de redes sociales de Data365. Aprenderá sobre bibliotecas útiles en Python, se adentrará en las complejidades de la integración y descubrirá cómo obtener datos actualizados sin comprometer la calidad ni arruinar su presupuesto.
En resumen: datos de Twitter = API + Python. Ese es el camino al éxito (compruébelo usted mismo).
¿Necesita recopilar tuits de ayer? Empiece con Data365 hoy para saber qué será tendencia mañana.
Breve resumen
- La extracción de tweets de Twitter mediante Python es posible de tres formas principales: un scraper propio, la API oficial de X o una herramienta de API de terceros.
- La API oficial de X es fiable y resiste una carga elevada; sin embargo, desde noviembre de 2026, cada lectura está sujeta a medición (0,005 $ por publicación), el uso está limitado a 3 millones de lecturas de publicaciones al mes y cualquier volumen superior requiere un contrato Enterprise personalizado, por lo que los costes aumentan rápidamente para proyectos con gran volumen de datos.
- Python ofrece muchas bibliotecas de código abierto para simplificar y ahorrar en el proceso de recuperación de tweets, pero los desarrolladores a menudo se quedan atascados con scrapers que dejan de funcionar debido a las estrategias anti-bot de X, los límites de velocidad y la infraestructura de X, que cambia constantemente.
- Las soluciones de terceros, como la API de redes sociales de Data365, suelen ser la opción preferida para equipos de desarrollo y empresas en crecimiento.
- La API de redes sociales de Data365 es totalmente compatible con Python y cualquier otro lenguaje de programación, incluidos JavaScript, Ruby, C#, etc.
- Data365 también ha optimizado la Social Media API con una gran escalabilidad, documentación clara, acceso sencillo mediante tokens y precios asequibles.
Opción n.º 1 para obtener datos de Twitter: combinación de API y Python
Cuando se trata de extraer tweets de Twitter usando Python, la mayoría de los programadores caen en la trampa de X. La API oficial grita literalmente: "¡Elígeme, soy fiable!". Aun así, solo resulta atractiva hasta que llega la factura. Vamos a analizarlo.
Los desarrolladores suelen combinar la API v2 de X (Twitter) con Tweepy, una biblioteca de Python gratuita y de código abierto que simplifica la integración. Y, en realidad, todo empieza muy bien: se instala mediante pip install tweepy, se obtiene el Bearer Token en el portal de desarrolladores y se empieza a consultar.
Pero aquí viene el problema: desde febrero de 2026, X factura el uso de la API por llamada, y los antiguos planes Free, Basic (200 $) y Pro (5.000 $) han desaparecido. A fecha de noviembre de 2026, esto es lo que marca el contador:
- Lectura de publicación: 0,005 $ cada una. Obtener 100.000 tweets para un modelo de análisis de sentimiento cuesta unos 500 $.
- Creación de publicación: 0,015 $ cada una, o 0,20 $ si la publicación contiene una URL.
- Límite mensual: 3 millones de lecturas de publicaciones. Más allá de eso, se necesita un contrato Enterprise con precios personalizados.
Vaya, su proyecto paralelo de análisis de sentimiento se ha convertido en una inversión de nivel empresarial. ¿Qué hacer entonces? No se preocupe. El sueño de obtener tweets sin complicaciones es posible, y aquí es donde puede encontrarlo.
Por qué los equipos eligen la API de redes sociales de Data365
Si desea obtener datos de Twitter, la combinación de API y Python es la mejor opción. Debido a su fiabilidad, escalabilidad y gran cantidad de funciones, los equipos eligen la API de redes sociales de Data365 para obtener datos públicos de Twitter de forma fácil y eficiente. Entre sus principales ventajas se incluyen:
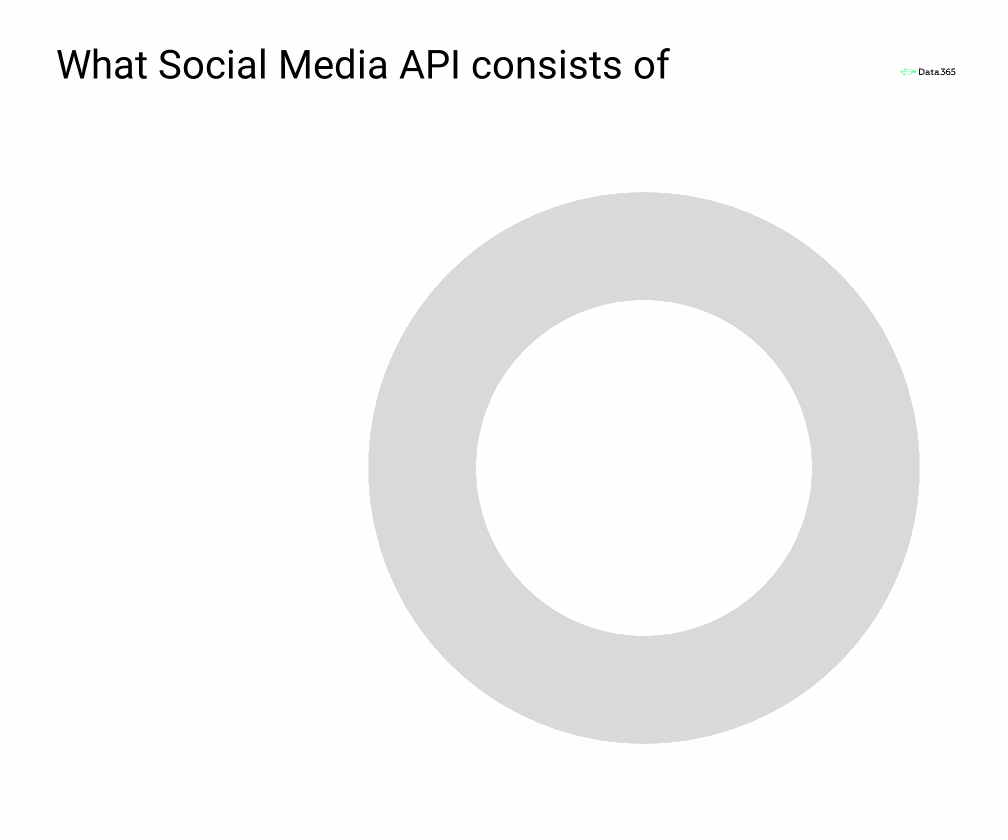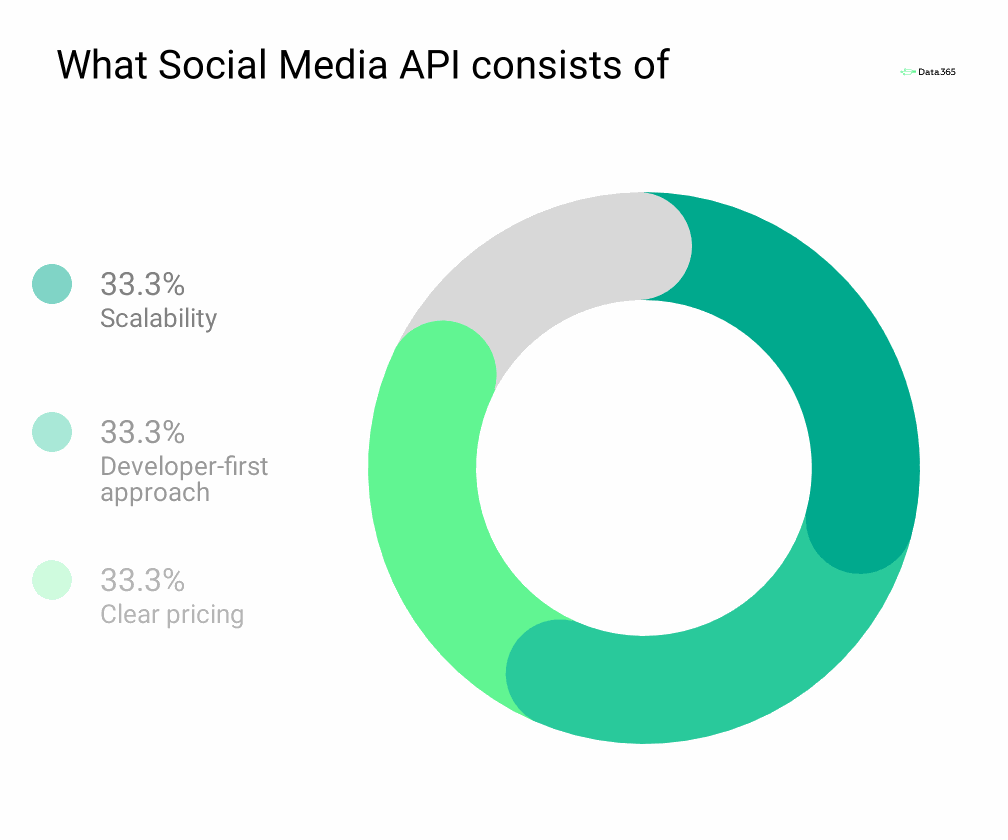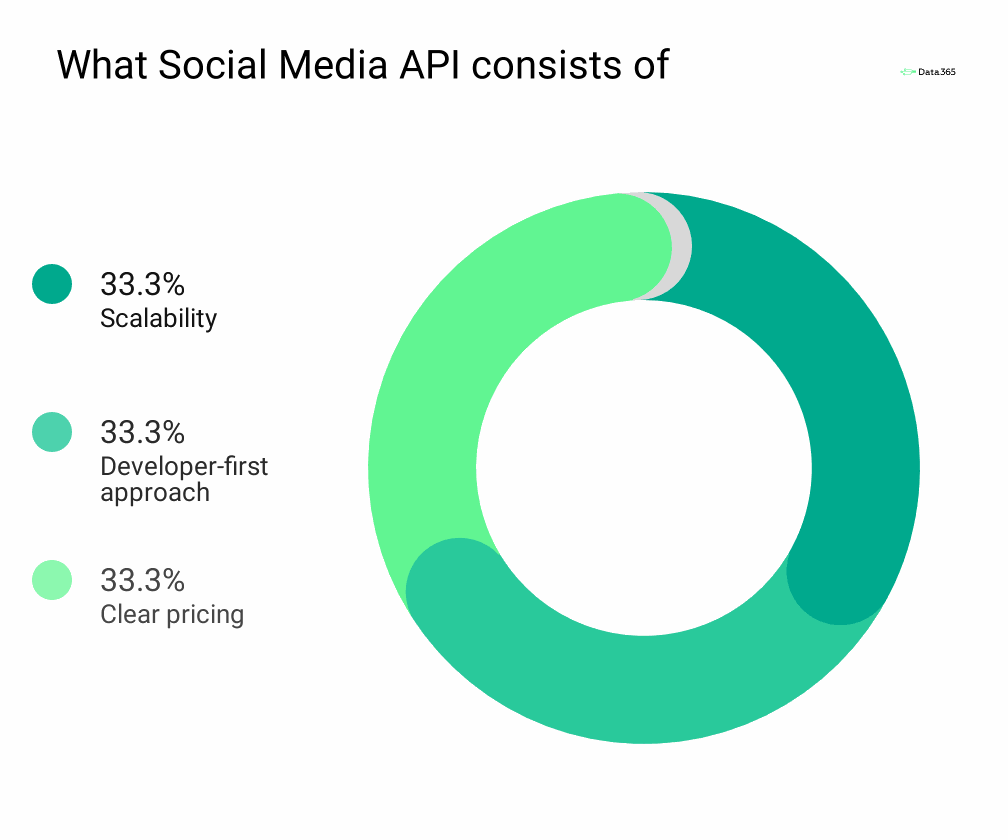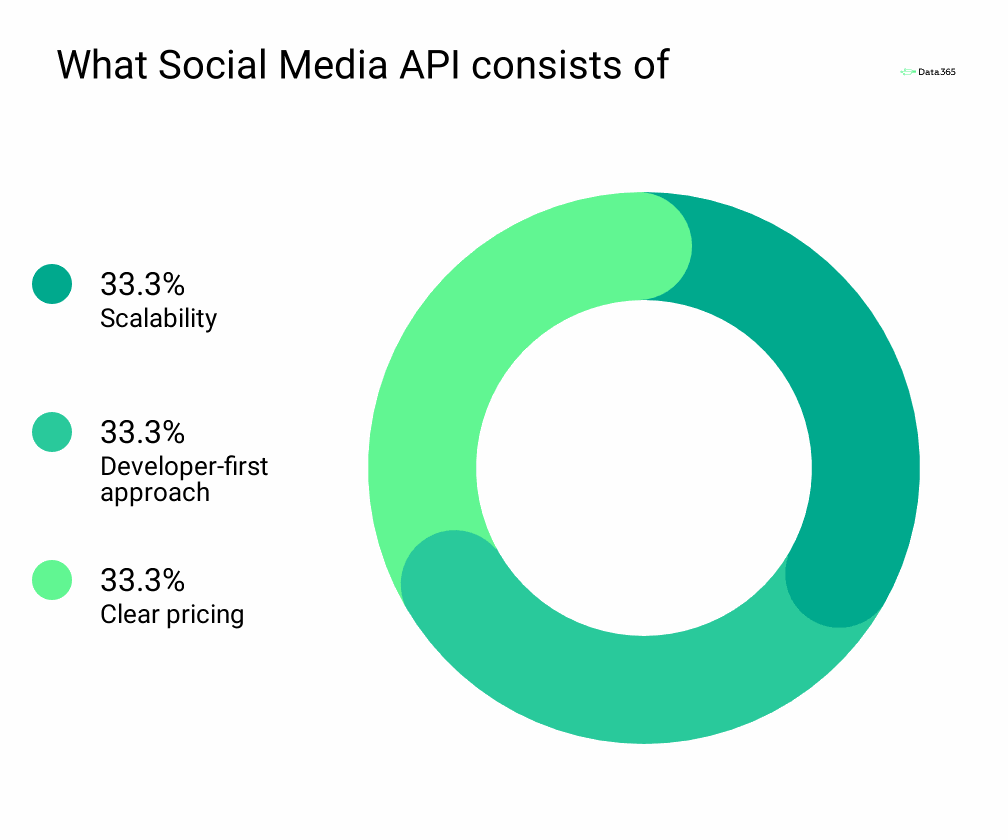
- Escalabilidad y fiabilidad: admite volúmenes de datos de cualquier tamaño con una disponibilidad del 99,9 %, algo fundamental para proyectos críticos. Data365 aplica las mejores prácticas de recopilación de datos en el servidor, sin ingeniería inversa ni automatización de navegadores.
- Enfoque centrado en el desarrollador: la amplia documentación de los productos, las excelentes guías de configuración y un equipo de asistencia personalizado facilitan la integración y la resolución de incidencias.
- Precios totalmente transparentes: tarifas claras de pago por uso que se adaptan a sus necesidades, con una prueba gratuita de 14 días.
Data365 también puede atender la mayoría de sus solicitudes de datos públicos de tweets utilizando estos endpoints:
- /twitter/post — obtenga la información de los tuits y sus metadatos.
- /twitter/profile — consulte la información del perfil de usuario.
- /twitter/post/search — busque por palabras clave y filtros.
- twitter/profile/search — busque perfiles de Twitter.
Y aunque Python es la opción preferida (con requests o httpx), la estructura RESTful de Data365 hace que funcione con casi cualquier lenguaje. Sin importar qué stack utilice: JavaScript (Node.js), Go, Java, C# o Ruby, solo tiene que enviar una solicitud HTTP autenticada. Esta técnica agnóstica al lenguaje facilita su adopción en equipos multidisciplinarios y elimina la dependencia de un solo proveedor.
¿Listo para probarlo? Reserve una llamada — su prueba gratuita ya está disponible.
Opción n.º 2: Código Python para obtener datos de Twitter
Para la mayoría, crear un scraper personalizado en Python equivale a desarrollar soluciones a medida. Para manejar páginas dinámicas, automatizar sesiones de navegador y trabajar con datos, las guías populares sugieren librerías como Selenium, Playwright, Pandas y BeautifulSoup. Aunque este método ofrece total flexibilidad con la lógica de scraping y la navegación por páginas, es una pérdida de tiempo técnica: los scripts deben mantenerse al día con los cambios en el diseño de Twitter, las estrategias anti-bot y los límites de velocidad, es decir, requieren actualizaciones constantes y suelen fallar.
Muchos también consideran snscrape como una solución rápida. Sin embargo, hay un inconveniente: dejó de funcionar en 2023 después de que X implementara un muro de inicio de sesión. Pero existe una alternativa. En lugar de luchar por superar las defensas de Twitter, colabore con una herramienta que opera según sus reglas. Ahí es donde entra en juego la API de redes sociales de Data365.
Considérelo un punto medio entre el poder de Python y la complejidad de Twitter. No hay necesidad de realizar ingeniería inversa en los endpoints ni de lidiar con navegadores headless. Con un código Python breve para obtener datos de Twitter usando requests o httpx y un único token, puede establecer los parámetros preferidos e iniciar el proceso de recuperación con endpoints bien estructurados. Data365 hace todo el trabajo pesado, como la gestión de límites de velocidad y el formato de datos, manteniendo su script estable.
Esta es una comparación directa de las razones por las que los equipos prefieren las API frente a los scrapers para sus procesos de negocio.
| Característica | Scraper de Python hecho a medida | API de redes sociales de Data365 + Python |
|---|---|---|
| Programación requerida | Sí (avanzada; Playwright/Selenium + rotación de proxies y lógica de límites de velocidad) | Mínima (llamadas HTTP RESTful estándar con autorización mediante token simple) |
| Mantenimiento | Manual (los selectores se rompen con cada actualización de la interfaz) | Gestionado completamente por el backend de Data365; endpoints estables |
| Alcance de los datos | Limitado a páginas extraídas manualmente | Endpoints de API estandarizados, acceso a múltiples redes sociales |
| Personalización de solicitudes | Cada nuevo tipo de datos requiere un script de scraping independiente | Una amplia gama de endpoints listos para usar (perfiles, búsquedas, publicaciones, comentarios, etc.) |
| Escalabilidad y limitación de tasa | Requiere lógica asíncrona personalizada y pools de proxies | Gestión de colas distribuida, control de concurrencia y lógica de reintento integrados |
| Fiabilidad / Tiempo de actividad | Baja (depende de controladores de navegador, bloqueos de proxy y actualizaciones de la interfaz) | 99,9% de tiempo de actividad, infraestructura monitorizada con gestión de errores |
| Formato de datos / Normalización | HTML no estructurado, requiere análisis | Salida JSON limpia con un esquema unificado entre plataformas |
| Integración | Difícil de integrar (emulación de navegador) | Integración REST sencilla con peticiones de Python |
| Ideal para | Proyectos experimentales o académicos puntuales | Canalizaciones de nivel de producción, equipos de investigación, entrenamiento de modelos de IA |
El coste real no es solo la infraestructura, es el coste de oportunidad. Cada hora dedicada a mantener un scraper frágil es una hora que no se dedica a crear funciones, entrenar modelos o generar información valiosa. Tenlo en cuenta al elegir.
Por qué usar datos de Twitter: API, Python e historias de éxito
Twitter no es solo una red social, sino el pulso de la conversación en tiempo real en todo el mundo. Ofrece información inmediata sobre lo que la gente piensa, siente y comparte. Mediante el uso de APIs y Python, los equipos pueden extraer tweets, que representan grandes volúmenes de datos de texto en tiempo real, listos para ser analizados o procesados mediante tecnologías de aprendizaje automático.
Casos de uso comunes
- Monitorización de marca y análisis de sentimiento — monitorice las menciones de marca, detecte crisis en fases tempranas y determine la percepción del público sobre las campañas de RR. PP.
- Previsión de tendencias — descubra nuevas tendencias o contenidos virales antes de que lleguen a los medios de comunicación convencionales.
- IA y aprendizaje automático — entrene modelos predictivos y de PLN alimentándolos con datos de tuits recientes y sin procesar.
- Investigación social y política — analice las conversaciones populares, opiniones y opiniones en torno a acontecimientos sociales o políticos.
- Ciberseguridad — realice un seguimiento de cuentas sospechosas o señales de alerta de amenazas para facilitar la detección temprana y la respuesta.
La API de redes sociales de Data365 ayuda a empresas y académicos a escalar sus actividades de datos en Twitter sin problemas de fiabilidad ni cumplimiento normativo:
Buzztech
Una plataforma de escucha social de Italia ha colaborado con Data365 para recopilar información bien estructurada en tiempo real y optimizar sus flujos de trabajo. Esto le permitió reducir los costes de adquisición de datos en un 30 % e impulsar una plataforma internacional de inteligencia social.
Una empresa de análisis de atención sanitaria
Utilizaron la Social Media API para extraer casi 7000 publicaciones en tiempo real y realizar un seguimiento del sentimiento durante la COVID-19. Como resultado, el equipo logró mejorar la eficacia de su comunicación y fomentar la confianza de la comunidad.
Eleve
Una plataforma húngara de defensa de marca colabora con nuestra API para realizar una monitorización intensiva de redes sociales y análisis de texto. La empresa busca identificar las audiencias objetivo y los influencers adecuados analizando desde cientos hasta miles de perfiles de usuario para cada cliente.
Una agencia de ciberseguridad
Esta empresa de ciberseguridad estadounidense llevó a cabo una exhaustiva campaña de investigación orientada a mejorar la seguridad del entorno digital. Gracias a Data365, recopilaron datos, incluidos tuits, y los integraron en un panel de monitorización de amenazas en tiempo real, aumentando la precisión de la detección gracias a un flujo continuo de datos.
Data365 equilibra potencia técnica y accesibilidad. Por eso, si necesita obtener datos de Twitter, la combinación de API y Python es la mejor inversión para su proyecto.
Reflexiones finales sobre la extracción de tuits con Python
El valor real de los datos frescos y estructurados de Twitter no se define por la cantidad de horas que pase depurando códigos de acceso, sino por la eficacia y fiabilidad de la herramienta de extracción elegida. Los scrapers prometen libertad, pero ofrecen inestabilidad. La API oficial ofrece cumplimiento normativo a un coste absurdo.
La API de redes sociales de Data365 soluciona ambas opciones: datos limpios y estructurados a un precio razonable, obtenidos mediante sencillas peticiones HTTP. Puede que esté entrenando modelos de IA, analizando el sentimiento de una marca o incluso trazando tendencias globales, pero el proceso de extraer tuits de Twitter usando Python debe ser estable, no estar sujeto a una depuración constante.
Deje de mantener scrapers. Empiece a generar insights. Reserve una llamada para obtener su prueba gratuita personalizada de 14 días con Data365.
Extrae datos de las principales redes sociales con la API de Data365
Solicita una prueba gratuita de 14 días y obtén más de 20 tipos de datos