Tanto Data365 como Apify ayudan a los equipos a recopilar datos públicos de redes sociales, pero se basan en conceptos diferentes. Data365 es una API única para redes sociales: una sola integración, un sistema de créditos y un equipo responsable de la infraestructura en ocho redes distintas.
Apify es una plataforma en la nube conocida principalmente por Apify Store, un mercado donde Apify y desarrolladores independientes publican miles de scrapers, llamados Actors. A continuación, comparamos ambos enfoques para ver cómo gestionan la integración, el soporte, los precios y los volúmenes de recopilación de muestras.
¿Quieres pasar directamente a la recopilación de datos de redes sociales? Programa una llamada con el equipo de Data365 y empieza a extraer información ahora mismo.
Data365 vs Apify: Dos enfoques distintos para los datos sociales
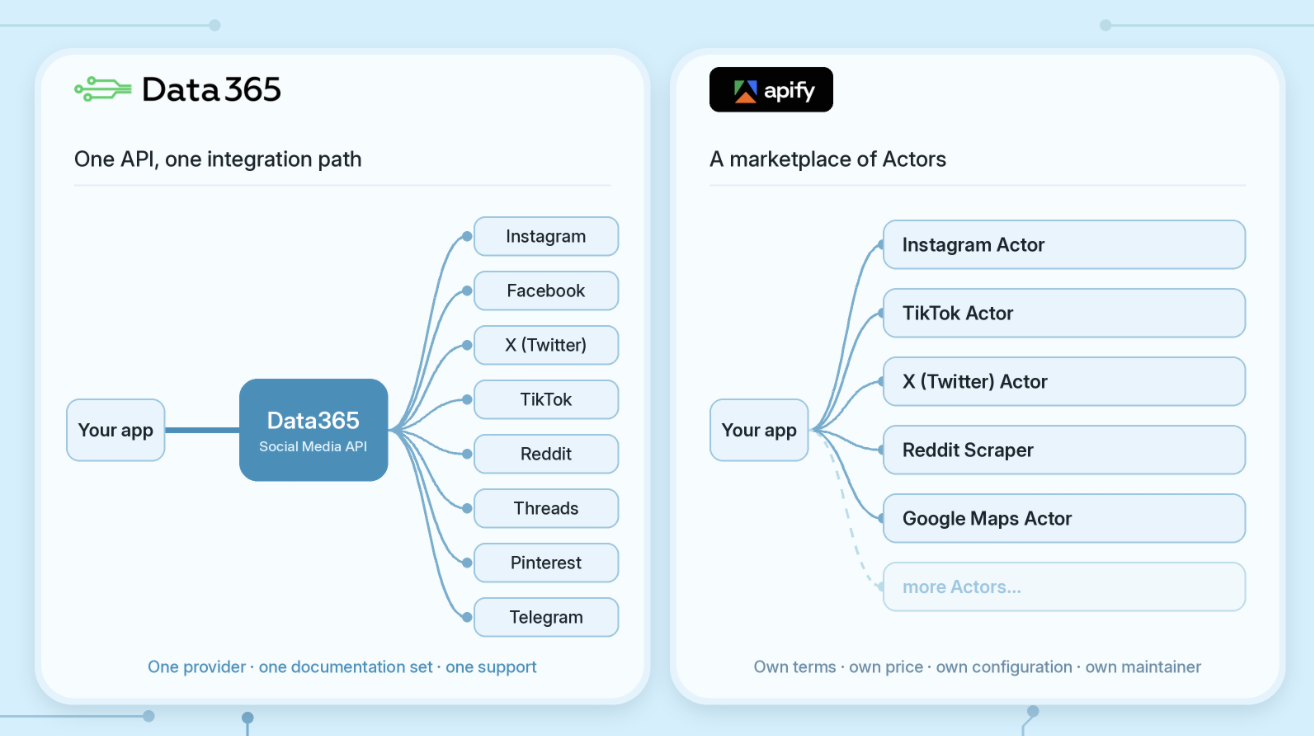
La forma más sencilla de plantear esta comparación es la siguiente: en Data365 ofrecemos un producto unificado, mientras que Apify gestiona una plataforma con un mercado integrado. Ambos pueden devolver datos públicos de redes sociales en formato JSON estructurado. Lo que cambia es el camino hacia esos datos y quién es responsable de cada paso del proceso.
Data365: una API diseñada para redes sociales
Data365 se ha enfocado exclusivamente en datos de redes sociales desde 2018. Nuestra API de redes sociales da acceso a datos públicos a través de una única integración para plataformas como:
Los datos se recopilan en tiempo real en el momento de la solicitud, en lugar de servirse desde una caché, por lo que recibes información actualizada y decides qué recopilar, cuándo y con qué frecuencia. Además, todas tus operaciones están respaldadas por un equipo técnico experto que se encarga del mantenimiento del producto.
Apify: un mercado de Actors
El núcleo de Apify es su Apify Store. Según su documentación, la tienda alberga miles de Actors, y la mayoría de ellos son creados y mantenidos por desarrolladores de la comunidad, no por la propia Apify. Además de redes sociales, los usuarios también pueden extraer datos de motores de búsqueda, mapas, plataformas de comercio electrónico, etc.
Este modelo de mercado aporta amplitud a Apify, pero también complejidad, ya que cada scraper tiene su propio conjunto de funciones, términos de uso y costes.
Por qué importa esta diferencia
En Apify, obtener datos sociales comienza por elegir un Actor, y cada uno viene con sus propias entradas, salidas, precios y responsable de mantenimiento. Un proyecto que abarque tres redes sociales puede implicar evaluar y mantener tres herramientas distintas. Con Data365, la elección se hace una sola vez: un proveedor, un conjunto de documentación y un soporte único para todas las redes compatibles.
Data365 vs Apify: Comparativa de funciones
La siguiente tabla resume cómo difieren ambos enfoques en los factores más importantes a la hora de planificar un flujo de datos recurrente.
En esencia, es una cuestión de elección: ¿necesitas acceso a una amplia gama de fuentes web o prefieres un flujo único de datos públicos de redes sociales? La siguiente sección explica cómo funciona Data365, desde la llamada inicial hasta el JSON final.
Cómo funciona Data365
La API de redes sociales de Data365 está diseñada para equipos que necesitan integrar datos sociales en sus productos, paneles de control o flujos de investigación de forma regular. En otras palabras, para equipos que requieren una conexión API única con un flujo de trabajo de recuperación coherente en todas las redes compatibles.
Llamada introductoria con un experto técnico
Una vez que hayas programado una llamada, tendrás una breve conversación con nuestro equipo para que podamos entender mejor las redes, los endpoints y los volúmenes que necesitas, y así ofrecerte la mejor propuesta. Después, recibirás una clave API personal, documentación y una colección de Postman para probar las solicitudes antes de pasar a producción durante una prueba gratuita de 14 días, sin necesidad de tarjeta de crédito.
Endpoints de datos que admitimos
La API de redes sociales solo obtiene información pública a la que se puede acceder sin iniciar sesión. Esto puede incluir:
- Perfiles: detalles de cuentas públicas, número de seguidores y otros campos de perfil compatibles.
- Publicaciones: texto, información multimedia disponible, marcas de tiempo y contadores de interacción pública.
- Comentarios: texto de comentarios de acceso público y campos relacionados, cuando sean compatibles.
- Búsqueda: consultas de palabras clave o hashtags compatibles, con restricciones específicas de cada red.
Para obtener información más detallada, los clientes pueden consultar la documentación creada específicamente para cada red, ya que los campos varían según la red y el endpoint. Esto ayudará a definir el alcance de tu colección con mayor precisión.
Un flujo de trabajo de recuperación en tres pasos
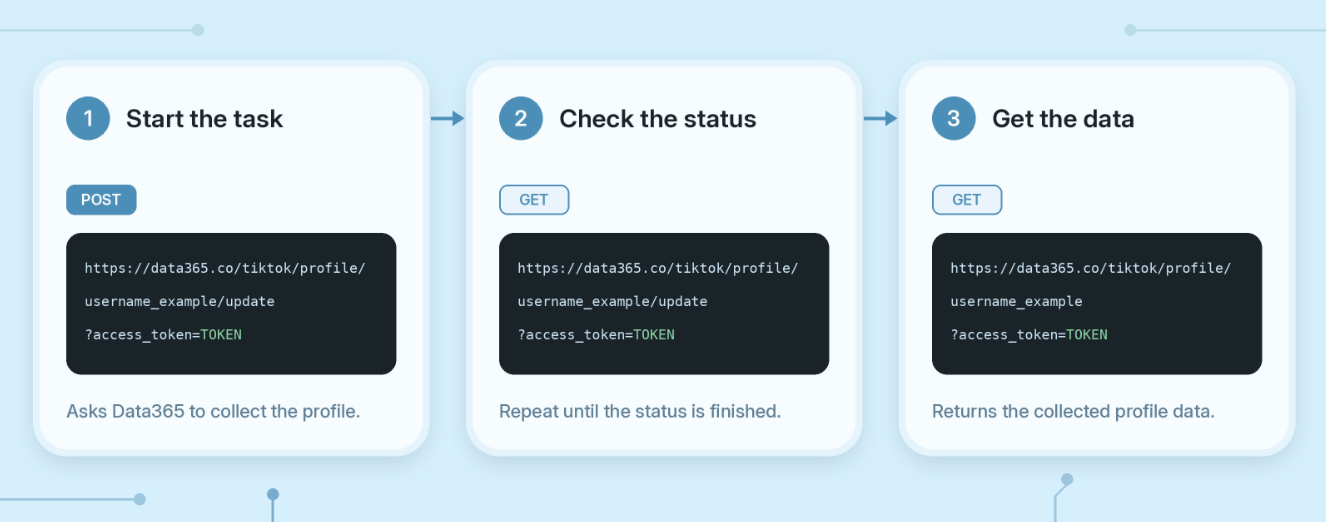
Todas las redes compatibles siguen la misma lógica de solicitud. El flujo de trabajo consta de tres pasos:
- Iniciar colección: Una solicitud POST inicia una tarea de colección utilizando un endpoint compatible con la red seleccionada.
- Comprobar estado. Envía una solicitud GET para ver si la tarea de colección se ha completado.
- Recuperar resultados. Una solicitud GET final devuelve un JSON estructurado, con campos específicos de la red cuando las plataformas difieren.
Cuando añades otra red compatible, puedes reutilizar el flujo de trabajo de solicitud mientras adaptas sus parámetros y los campos devueltos.
Soporte y personalización
Si tienes preguntas sobre la configuración, la integración o la disponibilidad de los datos, siempre puedes contactar a nuestro equipo de soporte por correo electrónico. Si los requisitos de tu proyecto van más allá de nuestra oferta estándar, también podemos hablar sobre opciones de personalización. Solo tienes que rellenar un breve formulario y programar una llamada para ponerte en contacto con nuestros expertos.
Cómo funciona Apify
Para iniciar un proceso, activa la ejecución de un scraper desde la consola de Apify, la API, la CLI, una programación o una integración. Apify verifica la solicitud, pone la ejecución en cola y la ejecuta en un entorno informático aislado. A continuación, el scraper lee su entrada JSON (que suele incluir URLs de inicio, límites y reglas de extracción) y coloca las URLs en una cola de solicitudes persistente.
Luego, extrae una URL de la cola, obtiene la página y ejecuta una función de JavaScript. Esa función filtra los campos deseados y los devuelve como registros estructurados. Si está configurado, busca enlaces que coincidan con los patrones permitidos, vuelve a añadir los enlaces no visitados a la cola y continúa el bucle hasta que la cola esté vacía o se alcancen los límites.
Las solicitudes devueltas se añaden al conjunto de datos predeterminado. Los resultados como archivos, HTML u otras salidas no tabulares pueden dirigirse a un almacén de clave-valor. El conjunto de datos se puede ver en Apify, descargar como JSON, CSV o Excel, o acceder a él mediante programación a través de la API utilizando el ID del conjunto de datos.
Precios de Data365 y Apify: cómo cada modelo define tu presupuesto
El precio es donde ambos enfoques divergen más. Data365 cobra por los datos, medidos en créditos. Apify cobra por el uso, y lo que cuenta como uso depende del Actor que ejecutes.
Data365: una asignación mensual fija de créditos
Cada plan de suscripción de Data365 incluye una asignación mensual de créditos y un número determinado de redes sociales. Los planes son:
- Básico: 300 €/mes por 1 red social y 500 000 créditos
- Estándar: 850 €/mes por 3 redes sociales y 1 000 000 de créditos
- Personalizado: precios negociados para hasta 8 redes y hasta 100 000 000 de créditos
El valor de los créditos es fijo según el tipo de solicitud: 1 crédito/publicación, 5 créditos/publicación con comentarios, 7 créditos/búsqueda y 9 créditos/perfil. Para calcular tu presupuesto, multiplica los registros que necesitas por su valor en créditos y elige el plan que cubra el total. Los costes de infraestructura no se cobran como conceptos independientes.
Apify: crédito de suscripción más precios por Actor
Los planes de pago de Apify incluyen un uso prepagado equivalente a la cuota de suscripción: Starter a 19 $/mes, Scale a 199 $ y Business a 999 $. Un plan gratuito incluye 5 $ de uso mensual. El consumo que supere el crédito incluido se factura bajo demanda, y la computación tiene un precio desde 0,20 $ por unidad de cómputo (CU) en el plan Starter hasta 0,13 $ en el plan Business.
La factura final también depende de cuál de los tres modelos de precios utilice el Actor elegido:
Qué significa esto para las previsiones
Con los Actores de pago por evento, la previsión es sencilla: multiplique los resultados por el precio del evento. Con los Actores basados en el uso, la factura depende de la duración de la ejecución, la memoria utilizada y el tráfico enrutado. Por ejemplo, una unidad de cómputo equivale a 1 GB de RAM durante una hora, y el tráfico de proxy residencial cuesta 8 $ por GB en el plan Starter. Con Data365, la estimación depende únicamente de los datos que solicite.
Escenarios de costes: perfiles y publicaciones de Instagram
Las cifras hacen que la diferencia sea concreta. Para los dos escenarios siguientes, comparamos Data365 con el Instagram Scraper de Apify (apify/instagram-scraper), un Actor mantenido por Apify que cobra por resultado con el uso de la plataforma incluido. Su precio publicado por cada 1.000 resultados es de 2,70 $ en el plan Free, 2,30 $ en Starter, 1,90 $ en Scale y 1,50 $ en Business.
Prueba piloto: 2.000 perfiles públicos de Instagram
Imagine un equipo que desea obtener información de perfil de 2.000 cuentas públicas, sin publicaciones ni comentarios, antes de comprometerse con un proveedor. Así es como cada opción gratuita gestiona la tarea:
- Data365: 2.000 perfiles × 9 créditos = 18.000 créditos. Durante la prueba gratuita de 14 días, puede probar los datos en su propio caso de uso. El alcance se acuerda en la llamada introductoria.
- Plan gratuito de Apify: 2.000 resultados × 2,70 $ por cada 1.000 = 5,40 $. Esto supera el crédito mensual de 5 $, por lo que completar la tarea dentro de un ciclo de facturación requiere un plan de pago.
En cualquier caso, esta pequeña prueba solo determina si los datos son adecuados para sus fines. Una vez que el proyecto entra en producción, surge la cuestión de los costes, como ocurre en el siguiente escenario.
Canalización mensual: 400.000 publicaciones públicas de Instagram
Ahora, el mismo equipo pasa a producción y recopila 400.000 publicaciones públicas al mes, sin comentarios. La tabla muestra la factura mensual estimada para cada opción:
El plan Basic de Data365 cubre toda la carga de trabajo y deja 100.000 créditos para otras solicitudes en la misma red. La factura más baja de Apify en este escenario, en el plan Scale, es de 760 $, de los cuales 561 $ corresponden a exceso de uso. Dado que los precios están en diferentes monedas, una comparación porcentual dependería del tipo de cambio, pero la brecha es clara: 300 € solo equivaldrían a 760 $ a un tipo de cambio superior a 2,53 $ por euro.
Data365 o Apify: ¿Cuál se adapta mejor a su proyecto?
Ambas herramientas son opciones legítimas, y la correcta depende de lo que su equipo esté construyendo. Si los datos de redes sociales son el núcleo de su producto o investigación, una API dedicada suele significar menos mantenimiento y costes más predecibles. Si las redes sociales son solo una fuente entre muchas, una plataforma general puede ser la mejor opción.
Elija Data365 si usted:
El argumento más sólido a favor de Data365 es una canalización recurrente construida en torno a redes sociales. Se adapta a equipos que:
- recopilan datos públicos de Instagram, Facebook, X (Twitter), TikTok, Reddit, Threads o Pinterest de forma regular
- desean una única integración y una lógica de solicitud coherente en todas las redes que utilizan
- prefieren presupuestar por volumen de datos en lugar de por cómputo, proxies y almacenamiento
- valoran el soporte directo del equipo que gestiona la API, incluidos los endpoints personalizados
Considere Apify si usted:
El modelo de mercado de Apify funciona bien en diferentes circunstancias. Puede adaptarse a equipos que:
- necesitan datos de muchas fuentes no sociales, como mapas, motores de búsqueda o tiendas online
- desean crear, alojar y publicar sus propios scrapers
- ejecutan trabajos pequeños y ocasionales que se ajustan a una asignación de uso gratuita o de nivel inicial
¿Listo para probar Data365 con tu propio caso de uso? Programa una llamada con nosotros para comenzar tu prueba gratuita de 14 días.
Extraiga datos de cinco redes sociales con la API Data365
Solicita una prueba gratuita de 14 días y obtén más de 20 tipos de datos